
ESMO Congress 2026 · 会议观察
ESMO 2026:AI 走进试验现场,还没走到病床边
ESMO 2026 有 200 多篇摘要提到 AI,三篇登上 late-breaking 讲台。最值得看的是已经进入试验作业的工具:替 ADC 试验判读肿瘤影像(131P),从一张病理切片预筛 12 种肺癌生物标记(320P),从病历抽出治疗线别(145P)。多数研究仍是回溯分析,离改变病人结局还很远。
/ 01 /
讲台上的三篇:题目大,证据早
以 artificial intelligence、machine learning、LLM、deep learning、digital pathology 等关键词对官方议程公开的一般摘要做全文检索(题名加内文),得到 197 篇;加上一场 AI 口头报告和三篇 AI LBA,约 201 篇。ESMO 没有公布 AI 摘要总数,这个数字只用来估规模。
LBA18(BEAGLE®-MDT,Histofy 出资)让 AI 替 15 个合成的大肠直肠癌病例写病人摘要、提出处置建议并配对临床试验,5 位专家用 5 分量表盲性评分。三项平均分分别落在 4.50–5.00、4.07–4.87 和 4.33–4.93。作者写明,这不能证明临床效益,需要前瞻验证。
LBA19(ALLIANCE,NCT07198581)是三篇中唯一的随机试验,由韩国天主教大学仁川圣母医院主导。单一中心的乳癌或大肠直肠癌化疗病人按 1:1 分到「医师可咨询 LLM」或常规照护,原订收 60 人后做期中分析并停止收案,最后分析 56 人。LLM 组记下的不良事件较多(150 对 78 笔,每人 5.4 对 2.8,p=0.006),减量比例相近(12/28 对 14/28)。主要终点是 EORTC QLQ-C30 整体健康状态的变化,但治疗结束时只有略多于一半的病人可评估,毒性分类也是事后分析。LLM 组多记下的副作用代表照护改善还是记录方式不同,期中分析无法区分。
LBA20(无资金)用 70,000 张 H&E 全切片训练模型,模拟 70 基因复发风险检测 MammaPrint,再用 RASTER 前瞻世代的 372 位早期乳癌病人回溯验证。中位追踪 10.3 年,模型判为低风险者的 10 年乳癌特定存活为 98.1%,高风险者为 86.7%(HR 0.12,95% CI 0.04–0.39)。两组接受化疗的比例差很多(74% 对 24%)。这是预后分层,不告诉医师谁会从治疗获益。
三篇都在 10 月 24 日下午报告(马德里时间):LBA18 14:45–14:55,LBA19 14:55–15:05,LBA20 15:39–15:49。
设计|LBA18 BEAGLE®-MDT:合成病例先导;LBA19 ALLIANCE:随机期中分析;LBA20 数位 MammaPrint:回溯验证。
分母|LBA18 BEAGLE®-MDT:15 个合成病例、5 位评分专家;LBA19 ALLIANCE:分析 56 人;LBA20 数位 MammaPrint:验证 372 人。
主导/资金|LBA18 BEAGLE®-MDT:作者;Histofy;LBA19 ALLIANCE:韩国天主教大学仁川圣母医院;LBA20 数位 MammaPrint:作者;无资金。
能回答的问题|LBA18 BEAGLE®-MDT:可行性;LBA19 ALLIANCE:安全性与可行性;LBA20 数位 MammaPrint:预后分层。
/ 02 /
真正的新闻在海报区:AI 进入试验作业
131P 把 AI 用在药物试验本身的疗效评估流程。Pfizer 是法律责任单位,也是出资方。研究对象是 PD-L1 导向的 ADC fetrastobart vedotin(代号 PDL1V/PF-08046054)的第一期试验(NCT05208762),收入 55 位非小细胞肺癌病人,按 PD-L1 阳性(37 人)与阴性(18 人)分层。研究者用 RECIST 1.1 判读的结果,和经人工覆核的 AI 辅助中央判读并排比较,病人层级一致率 84.0%,时间点层级 72.3%。
这是单臂研究的探索性终点,比的是两种判读方式是否一致,不是药物疗效。摘要作者写,AI 辅助中央判读得到的确认客观缓解率和疾病控制率与研究者判读一致,独立的 AI 辅助中央判读确认了研究者判读的结果,并以此支持第三期 PADL1NK-005;作者也说,这显示前瞻试验使用 AI 辅助 RECIST 1.1 判读可行。这是作者的说法,不代表疗效已获确认。下一步要看 PADL1NK-005 是否沿用同一套判读流程。
收案筛选是另一条线。124P(作者自行执行,无资金)用神经符号 AI 替 76 位肺癌病人配对 17 个试验,采前瞻「silent trial」设计:AI 在背景运作、不介入照护,结果再和 5 位肿瘤科医师的共识比对。每例筛选时间从 4.46 分钟降到 1 分钟,49.4% 的病例列为高信心自动筛选,摘要报告没有伪阳性。132P(Paradigm Health 与 Fujitsu 出资)用推理型 LLM,把一项跨国试验的收案条件套到 353 位日本肺癌病人,共 3,530 组病人与条件的配对。327 位(92.6%)至少一项不符,其中 299 人(分母 350)是组织亚型证据不足。
132P 的结果指向病历本身:AI 筛得更快,也照出病历缺了哪些数据。
真实世界证据也开始交给 AI 整理。145P(作者自行执行,无资金)让一个会自行调用检索工具的 LLM agent,从大肠直肠癌病历抽出治疗线别,再和肿瘤科医师逐份人工审阅的 100 位病人、430 条治疗线比较。agent 完成全部 100 例,88% 病人的线数误差在一线以内(ICC 0.90)。完整处方的正确率 76.3%,和第二位肿瘤科医师与第一位的一致率 73.9% 相近(McNemar p=0.68)。人工审阅每位病人约需一小时。
这四篇都在单一场域进行。124P 不介入照护,132P 和 145P 是回溯分析。要真正上线,还得处理数据主权和稽核轨迹。
/ 03 /
从切片读出分子:数位病理与病人选择
320P 是本文选读篇目中病例数最多的一篇。Tempus AI 是法律责任单位,Pfizer 出资。模型从晚期非小细胞肺癌的 H&E 全切片同时预测 12 种生物标记,数据涵盖 56,969 位病人的 60,459 个病例,其中 41,680 例也有 IHC 结果。研究先把阈值设在 90% 敏感度,再到保留测试集验证。所有标记的敏感度都高于 80%,ALK 融合为 92.49%(ROC AUC 90.06%),EGFR 为 89.38%(AUC 88.37%)。代价是特异度偏低,落在 41.66% 到 78.26% 之间。作者把它定位为预筛,用来推动后续的确诊检测,不取代 NGS 或 IHC。
315P 走同一条路,换成影像。韩国延世大学医疗体系主导、韩国国家研究基金会出资,用双参数 MRI 辨识晚期前列腺癌的 BRCA1/2 突变,收入两家医院 569 位病人。两组外部验证的 AUROC 为 0.813 和 0.817。把敏感度固定在 0.85 时,阴性预测值为 0.96,合并外部世代可少做 55.1% 的 NGS。但两组外部验证各只有 15 和 21 位 BRCA 阳性病人,置信区间很宽(0.633–0.954 和 0.691–0.918)。
306P 用随机试验数据检验「治疗交互作用」。Ataraxis AI 是开发商,也是出资方,用其因果 AI 数位病理模型 ATX 分析 UNIRAD 试验(NCT01805271)中 570 位淋巴结阳性、HR+/HER2- 早期乳癌病人。模型把 267 人(47%)列为高风险,风险分组与 everolimus 治疗组别之间出现交互作用(交互作用 HR 3.29,95% CI 1.19–9.10,p-interaction 0.022)。这是开发商自行执行的事后次分析,只能当假说。
550P 未显示显著交互作用。NSABP Foundation 主导,NSABP Foundation 与 PreciseDx 出资,用 AI 判读的组织分级(AI-Grade)分析 NSABP B-20 试验的 1,607 位荷尔蒙受体阳性、淋巴结阴性乳癌病人,中位追踪 14.2 年。AI-Grade 高风险者接受辅助化疗后远端复发风险较低(HR 0.60,95% CI 0.41–0.87,10 年绝对差 12%),低风险者则无显著差异(HR 0.81)。但两组的化疗效益没有显著交互作用(p=0.23),所以还不能说 AI-Grade 预测化疗效益。它的预后信号较清楚:只用 tamoxifen 的病人中,高低风险组 10 年无远端复发比例为 71.7% 对 89%(HR 2.33)。
551P 在临床高风险病人身上找低风险者。Karolinska 大学医院主导、无资金,用第三期 PANTHER 试验(NCT00798070)瑞典与德国场域的 620 位淋巴结阳性 ER+/HER2- 病人,独立验证一套 AI 预后检测。只用一张 H&E 切片的模型把 23.7% 病人列为低风险,这群人的 10 年无乳癌复发存活为 95.5%,非低风险者为 76.9%(校正 HR 3.88,95% CI 1.77–8.50)。在这群原本会被考虑加强辅助治疗的病人中,AI 找出约四分之一预后很好的人。
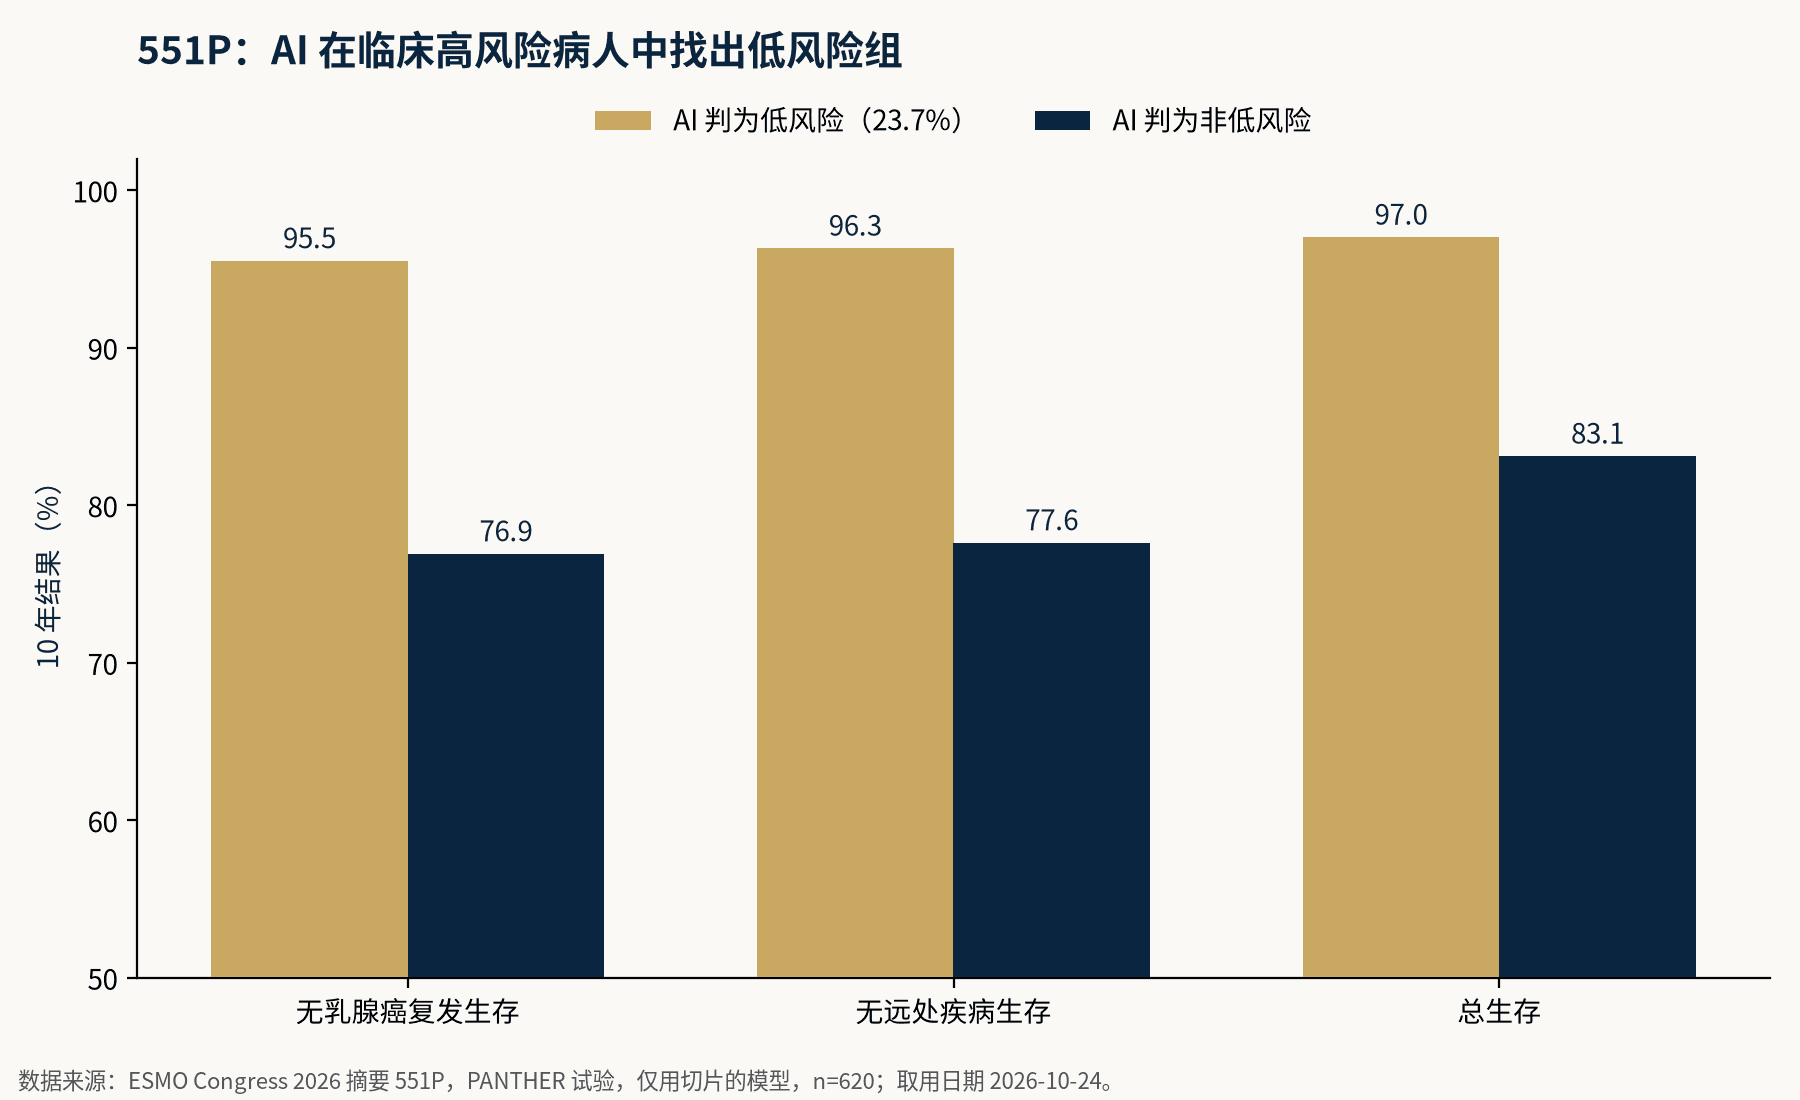
551P:PANTHER 试验 620 位临床高风险病人中,仅用切片的 AI 模型判为低风险与非低风险者的 10 年结果。
数据来源:ESMO Congress 2026 摘要 551P(取用日期 2026-10-24)。
287P 处理 ADC 时代最实际的病理问题:怎么判 HER2-low 与 HER2-ultralow。法国 Institut de Cancérologie de l'Ouest 主导、AstraZeneca 出资,让 7 家 AI 工具判读两家法国实验室的 297 例 ER+ 乳癌,再和专家共识及 Labcorp 结果比较。工具身分匿名,各家判读的片数也不同,还看不出哪一家可用。对适应症是 HER2 低表现的 ADC 来说,判读一致性直接决定谁能用药。
320P|主导/资金:Tempus AI;Pfizer;输入:肺癌 H&E 切片;病人数:56,969 人;主要结果:12 标记敏感度皆 >80%;证据性质:回溯,保留测试集。
315P|主导/资金:延世大学;韩国国家研究基金会;输入:前列腺 MRI;病人数:569 人;主要结果:外部 AUROC 0.81–0.82;证据性质:回溯,两组外部验证。
306P|主导/资金:Ataraxis AI;输入:乳癌 H&E 切片;病人数:570 人;主要结果:交互作用 HR 3.29;证据性质:随机试验事后分析。
550P|主导/资金:NSABP Foundation;PreciseDx;输入:乳癌 H&E 切片;病人数:1,607 人;主要结果:化疗效益交互作用 p=0.23;证据性质:随机试验次分析。
551P|主导/资金:Karolinska 大学医院;输入:乳癌 H&E 切片;病人数:620 人;主要结果:低风险组 10 年 BCRFS 95.5%;证据性质:随机试验独立验证。
一个 H&E 切片或一组 MRI 影像,正被用来推估过去要靠分子检测或人工判读的信息。能否取代部分检测,要看外部验证和监管能否跟上。
/ 04 /
多模态预后模型:数量多,多半还在回溯
另一群摘要结合临床、基因体、蛋白体或影像数据预测病人结局。
317P(TRIAGE-IO,Therapanacea 开发、Bpifrance 出资)预测晚期非小细胞肺癌病人接受一线 PD-1 单药后 6 个月内死亡的风险,训练 166 人、外部验证 105 人(25 例早期死亡),合并阴性预测值 0.925、敏感度 0.880。2930P(作者自行执行,无资金)用 20 个蛋白的 Random Forest 分类器预测局部晚期胃癌术前免疫化疗反应,160 位病人中,训练、内部与外部验证的 AUC 为 0.826、0.865 和 0.727,PD-L1 CPS 只有 0.561;但外部验证只有 35 人。197P(作者自行执行,无资金)用可解释机器学习预测 enfortumab vedotin 治疗后的存活,数据来自 24 国 51 个中心的 544 位晚期尿路上皮癌病人,最好的模型 C-index 约 0.60。
175P(法律责任单位为作者本人,挪威癌症协会出资)用治疗前的常规检验数据预测免疫检查点抑制剂的 3 级以上毒性,在 Dana-Farber 的 2,028 人建模,再到 Yale 的 628 人外部验证。外部 C-index 只有 0.60 到 0.64,但最高与最低三分位的风险差距明显,3 个月内 HR 3.18(95% CI 1.54–6.57)。4431P(Karolinska Institutet 主导,瑞典癌症协会等基金会出资)用 10 项常规临床数值,在定序前预测转移性前列腺癌病人的 ctDNA 比例是否达 8%,这是液态切片可靠侦测 BRCA1/2 变异的门槛。外部验证 AUC 0.83,依模型挑选病人后,ctDNA 阴性的液态切片从 24% 降到 5%。
这些模型可以当富集策略的假说来源,但都还没有前瞻验证,数字之间也不能互相比较。197P 和 175P 的 C-index 停在 0.6 左右,说明即使数据够多,治疗后的存活和毒性仍不容易预测。4431P 已经在进行 300 人的前瞻验证,是少数讲得出下一步的模型。
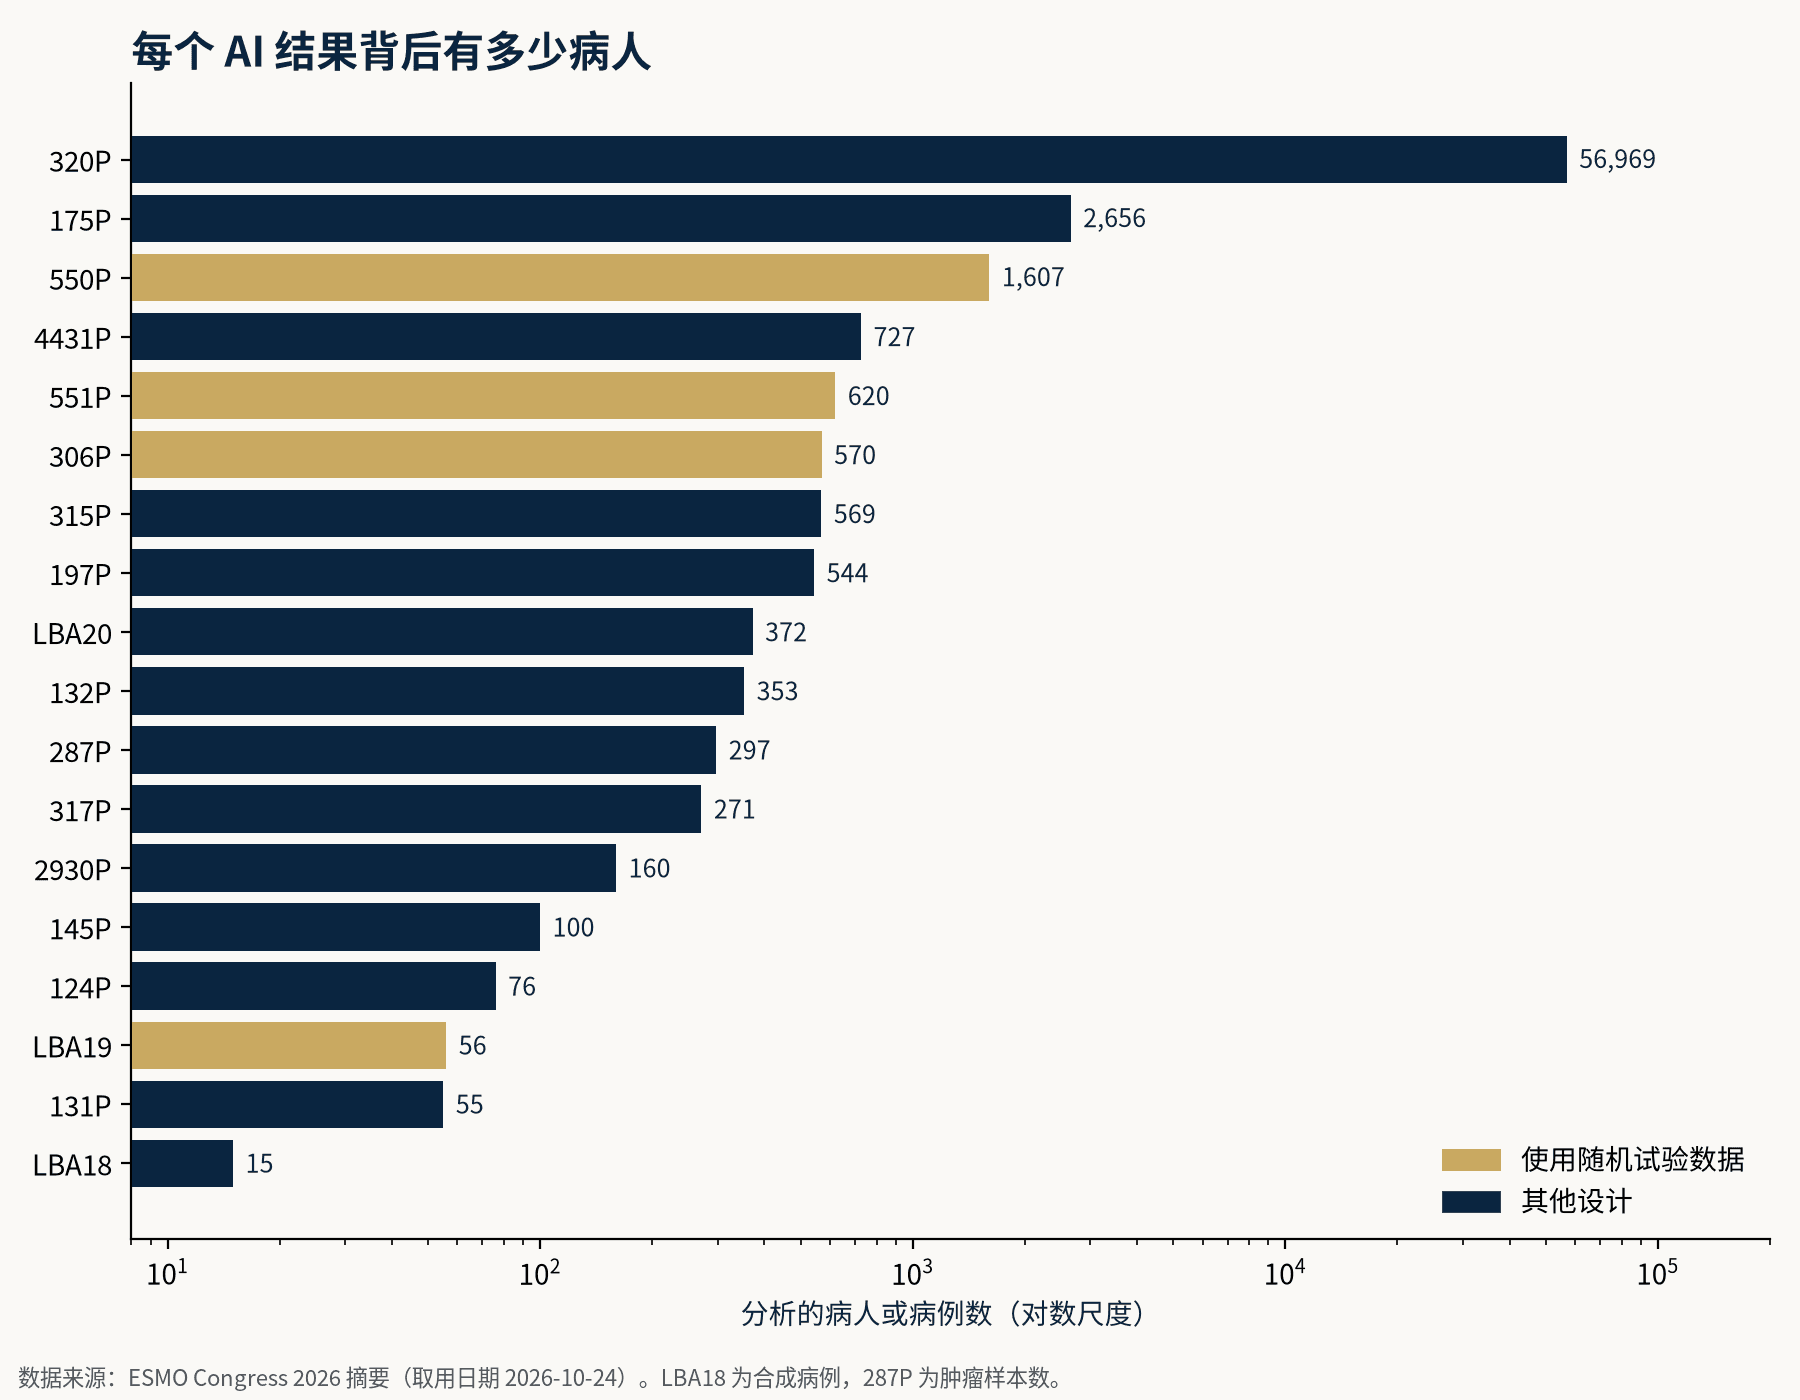
本文提到的各项 AI 研究分析的病人或病例数(对数尺度),金色为使用随机试验数据者。LBA18 为合成病例,287P 为肿瘤样本数。
数据来源:ESMO Congress 2026 摘要(取用日期 2026-10-24)。
/ 05 /
缺口:AI 还没碰到最难的问题
10 月 26 日还有一场 AI 口头报告,题目包括欧洲跨中心的联邦式真实世界证据平台(117RO,OPTIMA)、用常规临床数据自动做多癌别风险分层(280RO)、跨五种癌别验证人机互动的 in-silico 平台(171RO,CHAIMELEON)、阿根廷医院的 AI 胸部 X 光早期肺癌侦测(282RO),以及前列腺癌病人的 AI 辅助术前沟通随机第二期试验(173RO)。目前只公开题名,结果和主导单位要等报告后才知道。
把议程摊开来看,缺口很清楚。AI 已经在判读试验影像、筛选收案病人、整理病历、从切片推估分子状态。但在本文选读的篇目中,没有一篇直接回答药物开发最难的问题:哪一个 ADC 之后该接哪一个,新药该先在哪一群病人身上测,试验怎么设计才能更快得到答案。这些篇目中由药厂出资或主导的有三篇:Pfizer 的 131P 和 320P,以及 AstraZeneca 的 287P。这三篇用的都是 AI 最成熟的能力,也就是读影像或切片,不是设计试验。
接下来要看 PADL1NK-005 是否沿用 AI 辅助判读,HER2 AI 判读工具能否通过伴随诊断的监管关卡,ALLIANCE 的最终分析能否回答 LLM 对病人有没有好处。在那之前,AI 在肿瘤学仍是助手,不是决策者。